
录音文件识别
接口描述
本接口可对较长的录音文件进行识别
音频格式支持:mp3、wav、m4a、wma、aac、ogg、amr、fla;
视频格式支持:mp4、wmv、m4v、flv、rmvb、dat、mov、mkv、webm。
请求方法为 HTTP POST,
Content-Type 为 "application/json; charset=utf-8"。音频提交方式:本接口支持音频 URL、本地音频文件两种请求方式。
音频限制:音频 URL 时长不能大于 12 小时,文件大小不超过 1GB;本地音频文件不能大于 5MB。
如何获取识别结果:支持回调或轮询的方式获取结果。
识别结果有效时间:识别结果在服务端保存 24 小时。
接口要求
集成录音文件识别 API 时,需按照以下要求。
内容 | 说明 |
语言种类 | zh(中文)、en(英语)、yue(粤语)、ar(阿拉伯语)、de(德语)、fr(法语)、es(西班牙语)、pt(葡萄牙语)、id(印尼语)、it(意大利语)、ko(韩语)、ru(俄语)、th(泰语)、vi(越南语)、ja(日语)、tr(土耳其语)、hi(印地语)、ms(马来语)、nl(荷兰语)、sv(瑞典语)、da(丹麦语)、fi(芬兰语)、pl(波兰语)、cs(捷克语)、fil(菲律宾语)、fa(波斯语)、el(希腊语)、ro(罗马尼亚语)、hu(匈牙利语)、mk(马其顿语) |
支持行业 | 通用。 |
音频属性 | 采样率:16000Hz; 采样精度:16bits; 声道:单声道(mono)。 |
音频格式 | 音频格式支持:mp3、wav、m4a、wma、aac、ogg、amr、fla; 视频格式支持:mp4、wmv、m4v、flv、rmvb、dat、mov、mkv、webm。 |
请求协议 | https 协议。 |
请求地址 | https://asr-intl.cloud-rtc.com/v1/CreateRecTask?{request parameters}。 |
响应格式 | JSON。 |
数据发送 | 支持本地语音文件上传和语音 URL 上传两种请求方式。音频 URL 时长不能大于 12 小时,文件大小不超过 1GB;本地音频文件不能大于 5MB。 |
并发限制 | 默认单账号接口限频20次每秒,并发任务数上限200个。 |
说明:
同一 SDKAppID 下,直接接入 STT、AI 对话、AI 转录/翻译等所有实时语音识别场景共享该并发池,即各类型的并发路数合计不超过账号上限。一句话识别与录音文件识别独立计算,不占用实时识别并发额度。如您有更多并发需求,请 联系我们。
业务流程图
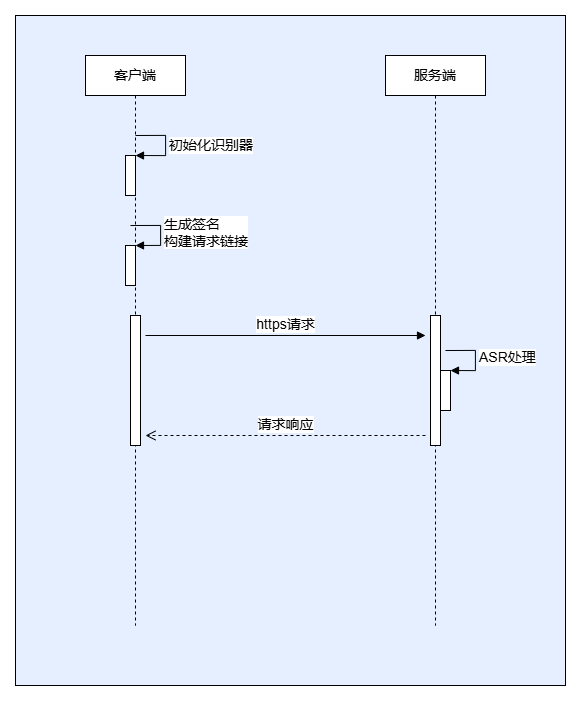
接口调用流程
请求格式
客户端发起 HTTP POST 请求,请求 URL 格式为:正式环境
https://asr-intl.cloud-rtc.com/v1/CreateRecTask?{请求参数}。在请求 header 中填写以下字段:
请求参数
请求参数格式为:
AppId=value1&Secretid=value2&Timestamp=value3&RequestId=value4。参数说明
参数名 | 必填 | 类型 | 描述 |
AppId | 是 | String | |
RequestId | 是 | String | 全局请求唯一 ID(UUID),该参数用来生成请求 UserSig。 |
Secretid | 是 | String | 腾讯云账号的 SecretId,可在 API 密钥管理中获取。 |
Timestamp | 是 | Integer | 当前 UNIX 时间戳,单位为秒。与当前时间差异过大可能导致签名过期。 |
输入参数
录音文件识别的请求消息体,格式为 json。
参数说明
参数名 | 必填 | 类型 | 描述 |
EngineModelType | 是 | String | 引擎模型类型,目前支持: bigmodel:大模型版。 |
ResTextFormat | 是 | Integer | 识别结果返回样式: 0:基础识别结果(仅包含有效人声时间戳,无词粒度的详细识别结果); 1:基础识别结果之上,增加词粒度的详细识别结果(包含词级别时间戳、语速值,不含标点); 2:基础识别结果之上,增加词粒度的详细识别结果(包含词级别时间戳、语速值和标点)。 3:包含词级详情和智能断句(词时间戳、语速、标点和智能断句)。 |
ChannelNum | 是 | Integer | 支持取值 1 或 2。当 ChannelNum=2 时,不能同时开启 SpeakerDiarization;左右声道通过 ChannelId 返回。 |
SpeakerDiarization | 否 | Integer | 说话人分离与角色认证配置。 0:不开启; 1:开启说话人分离,仅 ChannelNum=1 时可用; 3:在说话人分离基础上开启角色认证,需搭配 SpeakerRoles 或 VoiceprintIds 使用。 默认值 0。 |
SpeakerRoles | 否 | Array of SpeakerRoleInfo | 临时声纹信息,仅当前识别任务有效。与 SpeakerDiarization=3 配合使用。每个对象包含 AudioUrl(可公网访问的 WAV 声纹音频 URL)和 RoleName(角色名称)。声纹音频须为 10–30 秒清晰、有效的人声。 |
VoiceprintIds | 否 | Array of String | 已注册的声纹 ID 列表。与 SpeakerDiarization=3 配合使用,使用前需先完成声纹注册。 |
NoiseThreshold | 否 | Float | 噪音阈值。默认值 2.0,取值范围 [0.0, 4.0]。取值越大,音频片段越倾向被判定为噪音;取值越小,越倾向被判定为人声。 |
SourceType | 是 | Integer | 语音数据来源: 0:语音 URL; 1:语音数据(post body)。 |
CallbackUrl | 否 | String | 注意: 如果用户使用轮询方式获取识别结果,则无需提交该参数 建议在回调 URL 中带上您的业务 ID 等信息,以便处理业务逻辑。 |
Url | 否 | String | 语音的 URL 地址,需要公网环境浏览器可下载。当 SourceType 值为 0 时须填写该字段,为 1 时不填。音频时长不能超过 12 小时,音频文件大小不能超过 1GB。 |
Data | 否 | String | 语音数据,当 SourceType 值为 1(本地语音数据上传)时必须填写,当 SourceType 值为 0(语音 URL 上传)可不写。必须使用 Base64 编码(采用 Python 语言时注意读取文件应该为 string 而不是 byte,以 byte 格式读取后要 decode()。编码后的数据不可带有回车换行符)。音频文件大小不能超过 5MB(Base64 编码后)。 |
DataLen | 否 | Integer | 数据长度,单位为字节。当 SourceType 值为 1(本地语音数据上传)时必须填写,当 SourceType 值为 0(语音 URL 上传)可不写(此数据长度为数据未进行 Base64 编码时的数据长度)。 |
FilterDirty | 否 | Integer | 是否过滤脏词(中文普通话): 0:不过滤脏词; 1:过滤脏词; 2:将脏词替换为 \*。 默认值为 0。 |
FilterModal | 否 | Integer | 是否过滤语气词(中文普通话): 0:不过滤语气词; 1:部分过滤; 2:严格过滤。 默认值为 0。 |
FilterPunc | 否 | Integer | 是否过滤标点符号(中文普通话): 0:不过滤; 1:过滤句末标点。 默认值为 0。 |
ConvertNumMode | 否 | Integer | 是否进行阿拉伯数字智能转换: 0:不转换,直接输出中文数字; 1:根据场景智能转换为阿拉伯数字。 默认值为 1。 |
HotwordList | 否 | String | 临时热词表:该参数用于提升识别准确率。 单个热词限制:"热词|权重",单个热词不超过 30 个字符(最多 10 个汉字),权重 1-11 或者 100,如:"热词|5"; 临时热词表限制:多个热词用英文逗号分隔,最多支持 128 个热词,如:"热词|10,语音识别|5"。 注意: 热词权重设置为 11 时,当前热词将升级为超级热词,建议仅将重要且必须生效的热词设置到 11,设置过多权重为 11 的热词将影响整体字准率。 热词权重设置为 100 时,当前热词开启热词增强同音替换功能(仅支持 8k_zh, 16k_zh)。举例:热词配置"蜜制|100"时,与"蜜制"同拼音(mizhi)的"秘制"的识别结果会被强制替换成"蜜制"。 |
Language | 否 | String | 当 EngineModelType 指定 bigmodel 时,可指定音频语种。支持语种包括:zh(中文)、en(英语)、yue(粤语)、ar(阿拉伯语)、de(德语)、fr(法语)、es(西班牙语)、pt(葡萄牙语)、id(印尼语)、it(意大利语)、ko(韩语)、ru(俄语)、th(泰语)、vi(越南语)、ja(日语)、tr(土耳其语)、hi(印地语)、ms(马来语)、nl(荷兰语)、sv(瑞典语)、da(丹麦语)、fi(芬兰语)、pl(波兰语)、cs(捷克语)、fil(菲律宾语)、fa(波斯语)、el(希腊语)、ro(罗马尼亚语)、hu(匈牙利语)、mk(马其顿语)示例值:zh。 说明: 不填写该字段时,模型会自动识别语种。 |
响应格式
响应消息为 json 格式,所有返回字段都位于顶层 Response 对象之内。
参数说明
参数名 | 类型 | 描述 |
Response | Object | 顶层响应对象,包含以下字段。 |
Response.RequestId | String | 请求的 RequestId,定位问题时需要提供该次请求的 RequestId。 |
Response.Data | Object | 响应数据对象,包含以下字段。 |
Response.Data.RecTaskId | String | 该参数由服务端生成。录音文件识别的请求返回结果,包含结果查询需要的 RecTaskId。 注意: RecTaskId 有效期为 24 小时,不同日期可能出现重复 RecTaskId,请不要依赖 RecTaskId 作为您业务系统里的唯一 ID。 |
示例
用户通过
SourceType=1 请求录音文件识别,请求如下:请求网址:
https://asr-intl.cloud-rtc.com/v1/CreateRecTask?AppId=1234***5&RequestId=7737****81dd-4b60-a08b-b34ed46243a7
输入参数
{"EngineModelType": "bigmodel","ResTextFormat": 0,"ChannelNum": 1,"SourceType": 1,"Data": "xxxxxxxx","DataLen": 8}
响应结果
{"Response": {"RequestId": "24fe80e8-5b0c-4232-866f-4a402ee3127b","Data": {"RecTaskId": "TT1Ie0V0voyHKBrWqqUZw57smgjSR3K1eazaxrmIuEZoeyw+xUgmJ+Y5eli2U9Y2dcpUF4wsMOqPjQAPxw8bvcUoWTON2M6wjcBZcHtrpt0Dm"}}}
录音文件回调说明
录音识别请求中,如果用户设置了 CallbackUrl 参数,则通过回调的方式来返回识别结果,用户需要自行搭建可公网访问的 HTTP 或者 HTTPS 服务,并在创建录音识别任务时,将回调 Url 填写到 CallbackUrl 中。回调时,使用 HTTP 的 POST 方法,将所有内容放入 Body 中,Content-Type 为
application/x-www-form-urlencoded。回调 body 说明
回调 body 示例:
code=0&requestId=DYz1ieNlIyb5nZT+R9kQsCAocpoDD6l1qvqam7XBk78PDQ..&appid=12516****&projectid=0&text=%5B0&audioTime=8.420000&message=&resultDetail=
回调参数说明
名称 | 类型 | 描述 |
code | Integer | 任务状态码,0 为成功,其他:失败。 |
message | String | 失败原因文字描述,成功时此值为空。 |
requestId | String | 任务唯一标识,与录音识别请求中返回的 RecTaskId 一致。 |
appid | Integer | 请求的 AppId。 |
projectid | Integer | 项目 ID,默认为 0。 |
audioUrl | String | 语音 URL,如创建任务时为上传数据的方式,则不包含该字段。 |
text | String | 识别出的结果文本。 |
resultDetail | String | 包含详细识别结果,如创建任务时 ResTextFormat 为 0,则不包含该字段。 |
audioTime | Float | 语音总时长(秒)。 |
详细识别结果
SentenceDetail
单句的详细识别结果,包含单个词的时间偏移。
名称 | 类型 | 描述 |
FinalSentence | String | 单句最终识别结果。 注意: 此字段可能返回 null,表示取不到有效值。 |
WrittenText | String | 口语转书面语后的文本结果;仅开启对应能力时返回。 |
SpeakerId | Integer | 说话人 ID;开启说话人分离时返回。 |
SpeakerRoleName | String | 角色名称;SpeakerDiarization=3 且声纹匹配成功时返回。 |
SliceSentence | String | 单句中间识别结果,使用空格拆分为多个词。 注意: 此字段可能返回 null,表示取不到有效值。 |
StartMs | Integer | 单句开始时间(毫秒)。 注意: 此字段可能返回 null,表示取不到有效值。 |
EndMs | Integer | 单句结束时间(毫秒)。 注意: 此字段可能返回 null,表示取不到有效值。 |
WordsNum | Integer | 单句中词个数。 注意: 此字段可能返回 null,表示取不到有效值。 |
Words | Array of SentenceWords | 单句中词详情。 注意: 此字段可能返回 null,表示取不到有效值。 |
SpeechSpeed | Float | 单句语速,单位:字数/秒。 注意: 此字段可能返回 null,表示取不到有效值。 |
SentenceWords
识别结果中词文本,以及对应时间偏移。
名称 | 类型 | 描述 |
Word | String | 词文本。 注意: 此字段可能返回 null,表示取不到有效值。 |
StartTime | Integer | 在句子中的开始时间偏移量。 注意: 此字段可能返回 null,表示取不到有效值。 |
EndTime | Integer | 在句子中的结束时间偏移量。 注意: 此字段可能返回 null,表示取不到有效值。 |
回调状态码
数值 | 说明 |
10000 | 转码失败,请确认音频格式是否符合标准。 |
10001 | 识别失败。 |
10002 | 语音时长太短。 |
10003 | 语音时长太长。 |
10004 | 无效的语音文件。 |
10005 | 其他失败。 |
10006 | 音轨个数不匹配。 |
10007 | 音频下载失败。 |
录音文件识别结果查询
接口描述
调用录音文件识别请求接口后,有回调和轮询两种方式获取识别结果。采用回调方式时详见录音文件回调说明。
注意:
任务有效期为 24 小时,超过 24 小时的任务请不要再查询,且不要依赖 RecTaskId 作为业务唯一 ID,不同日期可能出现重复 RecTaskId。
当采用轮询方式时,需要主动提交任务 ID 来轮询识别结果,共有任务成功、等待、执行中和失败四种结果,具体信息请参见下文说明。
请求方法为 HTTP POST,
Content-Type 为 "application/json; charset=utf-8"。默认接口请求频率限制:50 次/秒。
内容 | 说明 |
请求协议 | https 协议。 |
请求地址 | https://asr-intl.cloud-rtc.com/v1/DescribeTaskStatus?{request parameters}。 |
响应格式 | JSON。 |
并发限制 | 默认单账号限制并发数为 50 次每秒。 |
请求格式
客户端发起 HTTP POST 请求,请求 URL 格式为:正式环境
https://asr-intl.cloud-rtc.com/v1/DescribeTaskStatus?{请求参数}。在请求 header 中填写以下字段:
请求参数
请求参数格式为:
AppId=value1&Secretid=value2&Timestamp=value3&RequestId=value4。参数说明
参数名 | 必填 | 类型 | 描述 |
AppId | 是 | String | |
RequestId | 是 | String | 全局请求唯一 ID(UUID),该参数用来生成请求 UserSig。 |
Secretid | 是 | String | 腾讯云账号的 SecretId,可在 API 密钥管理中获取。 |
Timestamp | 是 | Integer | 当前 UNIX 时间戳,单位为秒。与当前时间差异过大可能导致签名过期。 |
输入参数
录音文件查询接口的请求消息体格式为 json。
参数名 | 必填 | 类型 | 描述 |
RecTaskId | 是 | String | 从 CreateRecTask 接口获取的 RecTaskId,用于获取任务状态与结果。 注意: RecTaskId 有效期为 24 小时,超过 24 小时的 RecTaskId 请不要再查询。 |
输出参数
录音文件查询接口请求消息体响应格式为 json,所有返回字段都位于顶层 Response 对象之内。
参数名 | 类型 | 描述 |
Response | Object | 顶层响应对象。 |
Response.Data | TaskStatus | 录音文件识别的请求返回结果。 |
Response.RequestId | String | 唯一请求 ID,由服务端生成,每次请求都会返回(若请求因其他原因未能抵达服务端,则该次请求不会获得 RequestId)。定位问题时需要提供该次请求的 RequestId。 |
TaskStatus 结构如下:
名称 | 类型 | 描述 |
RecTaskId | String | 任务标识。RecTaskId 数据类型为 String。 |
Status | Integer | 任务状态码: 0:任务等待; 1:任务执行中; 2:任务成功; 3:任务失败。 |
StatusStr | String | 任务状态: waiting:任务等待; doing:任务执行中; success:任务成功; failed:任务失败。 |
Result | String | 识别结果。开启 SpeakerDiarization 时,结果中可能包含说话人标识,例如:[0:0.200,0:1.380,spk:1] hello。 |
ErrorMsg | String | 失败原因说明。 |
ResultDetail | Array of SentenceDetail | 识别结果详情。包含每个句子中的词时间偏移,一般用于生成字幕的场景。(录音识别请求中 ResTextFormat 不为 0 时该字段不为空)。 注意: 此字段可能返回 null,表示取不到有效值。 |
AudioDuration | Float | 音频时长(秒)。 注意: 此字段可能返回 null,表示取不到有效值。 |
Progress | Integer | 处理进度,单位为 1%。 |
查询示例
请求网址
https://asr-intl.cloud-rtc.com/v1/DescribeTaskStatus?RequestId=2f5e8263-a23b-4e65-be22-6b7c19bd4064&AppId=12345
输入参数
{"RecTaskId": "DYz1ieNlIyb5nZT+R9kQsCAocpoDD6l1qvqam7XBk78PDQ.."}
响应结果
{"Response": {"RequestId": "2f5e8263-a23b-4e65-be22-6b7c19bd4064","Data": {"RecTaskId": "DYz1ieNlIyb5nZT+R9kQsCAocpoDD6l1qvqam7XBk78PDQ..","Status": 2,"StatusStr": "success","AudioDuration": 2.38,"Result": "[0:0.200,0:1.380,spk:1] 您好。\n","ResultDetail": [{"FinalSentence": "您好。","SliceSentence": "您好","StartMs": 200,"EndMs": 1380,"SpeechSpeed": 2,"WordsNum": 1,"Words": [{"Word": "您好","StartTime": 200,"EndTime": 1380}]}],"ErrorMsg": ""}}}
开发者资源
SDK
Tencent-RTC SDK for go:Github
Tencent-RTC SDK for python:Github
Tencent-RTC SDK for nodejs:Github
Tencent-RTC SDK for java:Github
Tencent-RTC SDK for rust:Github
Tencent-RTC SDK for cpp:Github
SDK 调用示例
Java 示例
Rust 示例
CPP 示例